011 Prévoir plus juste aide-t-il à choisir les bonnes actions ?
Les modèles étudiés améliorent une mesure de prévision, mais ils ne classent pas clairement les actions dans le bon ordre. Le portefeuille des arbres obtient un meilleur résultat observé que celui de la régression. L'expérience ne démontre toutefois pas que les arbres prévoient mieux sur les données disponibles.
Cette distinction organise l'étude. Une prévision sert à annoncer un rendement. Un classement sert à choisir entre plusieurs actions. Un portefeuille transforme ensuite ce choix en positions, avec des risques et des frais.
Trois actions suffisent pour comprendre le problème
L'exemple suivant est fictif. Les rendements sont exprimés au-delà d'un placement sans risque, pour un seul mois. Le modèle annonce une hausse pour chaque action.
| Action | Rendement prévu | Rendement observé |
|---|---|---|
| A | +2 % | +4 % |
| B | +3 % | +3 % |
| C | +4 % | +2 % |
Le modèle se trompe de deux points de pourcentage sur A et C. Il prévoit exactement le rendement de B.
La somme des erreurs au carré vaut donc 2 × 2 + 0 + 2 × 2 = 8.
Prévoir zéro pour toutes les actions aurait donné 4 × 4 + 3 × 3 + 2 × 2 = 29.
Le R² hors échantillon mesure ici la réduction de cette erreur par rapport à la prévision nulle.
Il vaut 1 - 8 / 29, soit 72,4 %. Ce pourcentage ne compte pas les prévisions correctes.
Il compare deux sommes d'erreurs au carré.
Le classement est pourtant entièrement inversé. Le modèle préfère C, qui monte de 2 %, à A, qui monte de 4 %. Acheter l'action préférée donne donc le moins bon des trois rendements. L'exemple prouve que précision et classement peuvent diverger. Il ne reproduit pas la taille des effets observés dans l'étude.
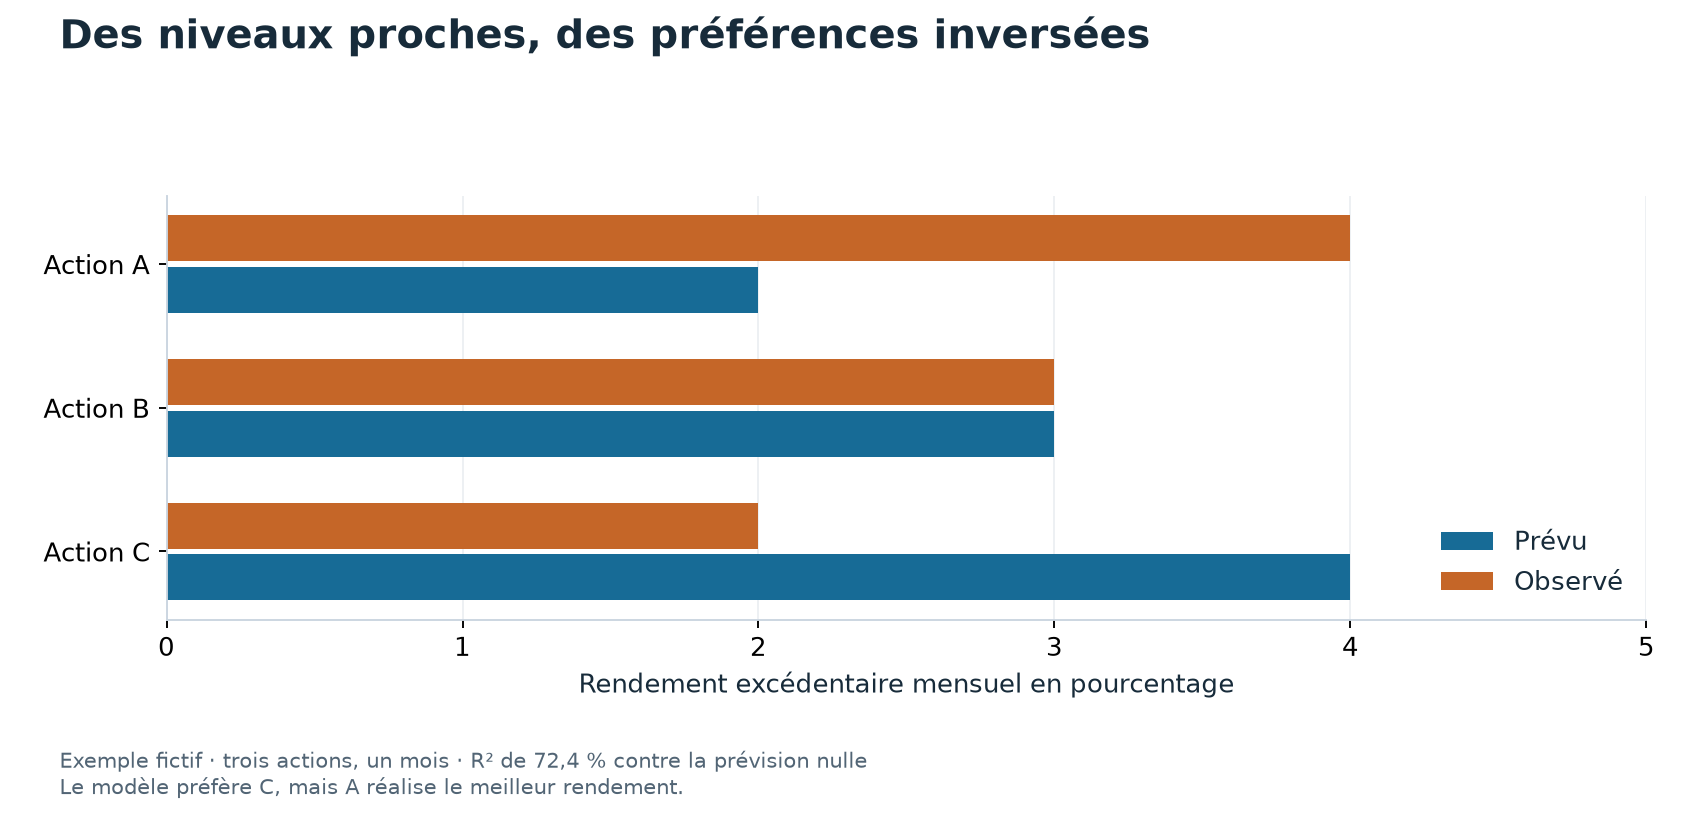
Chaque paire de barres représente une action. Le bleu montre la prévision et l'orange le rendement observé, en pourcentage mensuel. De A à C, la barre bleue s'allonge pendant que la barre orange raccourcit. Le modèle annonce la hausse générale, mais inverse les préférences.
Pourquoi la littérature compare plusieurs méthodes
Gu, Kelly et Xiu étudient comment les caractéristiques des entreprises renseignent sur leurs rendements futurs. Une caractéristique peut être utile en combinaison avec une autre. Par exemple, une hausse récente pourrait avoir une portée différente selon la liquidité du titre, c'est-à-dire la facilité de le négocier. Cet exemple explique ce qu'est une interaction. Il ne prétend pas identifier le mécanisme causal des résultats du laboratoire.
Une régression linéaire additionne les effets selon une forme fixée. Un arbre découpe les observations en groupes et peut employer des règles différentes selon le groupe. Cette souplesse peut aider à représenter une relation. Elle peut aussi apprendre des particularités accidentelles du passé. L'article de 2020 compare ces méthodes sur un panel d'actions américaines.
Ce que nous reproduisons et ce que nous adaptons
| Élément | Article de référence | Expérience du laboratoire |
|---|---|---|
| Univers | Large historique américain fondé sur CRSP | Grandes entreprises disponibles dans le panel construit pour l'étude 004 |
| Informations | Caractéristiques des titres et variables macroéconomiques | 27 caractéristiques, sans les interactions macroéconomiques du papier |
| Modèles | Méthodes linéaires, arbres et réseaux | Six méthodes, dont des arbres et des régressions, sans réseau dans la grille |
| Comparaison financière | Portefeuilles présentés dans le papier | Décile acheté et décile vendu, avec frais proportionnels modélisés |
Ces différences empêchent de traiter un écart de performance comme une réfutation générale de l'article. La question locale est plus étroite. Les arbres apportent-ils une amélioration détectable dans notre panel et avec notre protocole ? La fiche de littérature détaille les spécifications et les versions consultées.
Comment le test avance dans le temps
Les informations comptables portent une date de disponibilité. Les prévisions visent le mois suivant. Le modèle apprend sur les premières années, puis ses paramètres sont choisis sur une période de validation antérieure au test. Une séparation d'un mois empêche les étiquettes voisines de franchir la frontière retenue.
L'opération recommence en avançant dans le calendrier. Les résultats présentés couvrent 72 mois, de juillet 2020 à juin 2026. Un décile contient un dixième des titres classés. Le portefeuille achète le décile préféré et vend le moins préféré. Les coûts supposés valent dix points de base par unité négociée. Dix points de base correspondent à 0,10 % du montant concerné.
Les trois mesures racontent des choses différentes
| Modèle | Réduction de l'erreur par rapport à zéro | Corrélation moyenne du classement | Sharpe du portefeuille net |
|---|---|---|---|
| Régression pénalisée | 0,41 % | -0,022 | 0,277 |
| Arbres amplifiés | 0,35 % | -0,016 | 0,663 |
| Forêt aléatoire | 0,48 % | -0,019 | 0,572 |
La corrélation de classement compare l'ordre prévu à l'ordre observé chaque mois. Une valeur négative indique une association moyenne de sens opposé. Le ratio de Sharpe rapporte le rendement excédentaire moyen à sa dispersion. Il ne mesure pas directement la perte maximale.
La forêt réduit davantage l'erreur, tandis que les arbres amplifiés ont le meilleur Sharpe parmi les trois lignes. Les trois corrélations de classement sont négatives. Cela peut coexister avec un portefeuille profitable, car les déciles extrêmes ne résument pas tout le classement. Les écarts observés doivent encore être comparés à leur incertitude.
Les nombres proviennent des erreurs et classements et des portefeuilles. Les rendements de portefeuille sont nets des coûts de transaction retenus, mais pas de frais de gestion ou d'impôts.
Ce que le verdict permet de dire
Le test de comparaison des erreurs ne fournit pas de preuve suffisante en faveur des arbres amplifiés face à la régression de référence. Une absence de différence détectée n'établit pas l'égalité des méthodes. L'échantillon peut manquer de puissance, c'est-à-dire de capacité à détecter un petit effet.
Le panel contient aussi un biais de sélection des entreprises. Dater correctement leurs rapports ne restitue pas les titres absents du panel.
L'expérience ne permet donc pas de conclure que les modèles complexes sont inutiles en général.
Son verdict REJECTED signifie que les critères de cette étude ne sont pas satisfaits.
Refaire l'exemple et lire la preuve complète
uv run python scripts/build_learning.py --check vérifie les textes et les exemples hors réseau.
Le test retrouve un R² de 21 / 29 et un classement inversé.
L'annexe technique conserve les six modèles et leurs fenêtres.
L'étude 013 prolonge l'historique sans résoudre la sélection des entreprises.